越南外包团队多语言AI客服落地:显存与并发怎么配,一年要花多少钱
做 TikTok Shop、Shopee 或独立站的卖家,把客服团队放在越南胡志明市或河内已经不新鲜——人力成本低、小语种覆盖全。但真正开始做「多语言 AI 客服本地化」时,第一个卡点往往不是模型选型,而是:一台机器要多少显存、能扛多少并发、一年下来比雇人省多少。这笔账算不清,预算就没法批。
一、显存怎么算:从模型参数量倒推,别一上来就买卡
多语言客服的典型技术栈是「开源模型私有化 + RAG 知识库」,常见选择是 Qwen 系列的 7B/14B 版本或 Llama 3.1 8B,用 Ollama 或 vLLM 部署,前面挂一层检索服务读商品库和退换货政策。显存占用大致分三块:模型权重、KV Cache(上下文缓存)、框架开销。
- 模型权重:FP16 下每 10 亿参数约 2GB,7B 模型约 14GB;用 INT8 量化压到 7~8GB,INT4 可到 4~5GB 量级。客服场景对回答质量要求中等,INT8 通常是性价比平衡点。
- KV Cache:跟上下文长度和并发数线性相关。单条 2K 上下文、7B INT8 模型,每路并发大约再占 0.5~1GB,具体视框架而定。
- 框架开销:vLLM 一类框架本身吃 2~4GB 显存。
结论很直接:7B INT8 跑 10~20 路并发,24GB 显存的卡(如 4090、L4 级别)基本够用;要上 14B 或做 32B 的翻译增强,建议 48GB 起步。越南本地机房目前主流还是以物理服务器 + 单卡/双卡方案交付,云端 GPU 按小时计费,长期跑客服这种 7×24 负载,物理机月付更划算。
二、并发与带宽:客服是长连接,别按网页访问量估
多语言客服的真实并发远低于「访问人数」。一个日均 3000 会话的店铺,峰值同时在线咨询通常只有 20~50 路,AI 首响要求 2 秒内。按每路会话平均 3~5 次请求、每次输出 200 token 估算,7B INT8 在单卡上做到每秒 15~30 token 的输出速度是可预期的,够撑住这个量级。
带宽反而容易被忽略:越南服务器到东南亚各国以及回国内的线路质量差异大,客服要同时服务越南语、泰语、印尼语和中文买家。文字客服对带宽要求不高,10~20M 独享足够;但如果要做「文字 + 商品图 + 语音消息转写」,或者后续接数字人视频客服,就要按 50M 起算,并优先选大带宽不限流量的机型,避免月底被流量账单打脸。
另一个实操点:把模型推理放在越南本地机房,让越南外包客服团队就近调用,延迟从跨境访问的 80~150ms 降到 10ms 级,前端体验差别很明显;同时商品数据、买家对话不出境,对做欧盟、东南亚数据合规的卖家更省心。
三、成本账:把一次性投入和月度开销拆开
以 20 路并发、7B INT8 多语言客服为目标,一年期的花销大致如下(均为市场区间量级,视服务商而定):
- 算力主机:带 24GB 显存级别 GPU 的物理服务器,越南机房月付通常在数百到一两千元区间;纯 CPU 跑小模型或做 RAG 检索节点,月付可低至两三百元。
- RAG 与业务服务:检索服务、向量库、工单系统可以合并在同一台 64G 内存的机器上,不必单独采购。
- 人力:越南本地客服外包约每人每月 3000~6000 元人民币量级,AI 接手 60%~70% 的常规咨询后,3 人团队可压到 1~2 人做兜底和质检。
- 隐性成本:模型微调、知识库清洗、多语言语料校对,通常需要 1~2 人月的前期投入,这部分最容易被漏算。
粗算下来,自建方案的第一年总投入通常低于同等规模 SaaS 客服的年费加超额会话费,第二年起优势更明显,前提是会话量稳定、知识库复用率高。
四、从 0 到 1 的落地步骤与避坑
- 先跑通再扩容:用一台 64G 内存、带单卡的机器部署 Ollama + 7B INT8 模型,接 200 条真实历史会话做评测,看多语言回答准确率是否过 80%。
- 知识库分层:商品参数、物流时效、退换货政策分开建索引,越南语和泰语的关键词要人工校对,机器翻译直接入库是最大的坑。
- 灰度切流:先让 AI 处理售后查询类问题,人工只做转接和兜底,观察两周再放开售前咨询。
- 选机器看四件事:GPU 型号与显存、内存是否 64G 起、带宽是否独享不限流、机房到目标市场的线路质量。越南自营机房在这几点上通常比转售资源更可控,工单响应也更快。
- 避坑:不要用家用级显卡跑 7×24 生产负载;不要为了省钱选共享带宽;不要忽略模型更新后的回归测试,换模型等于换了一套话术。
选购推荐
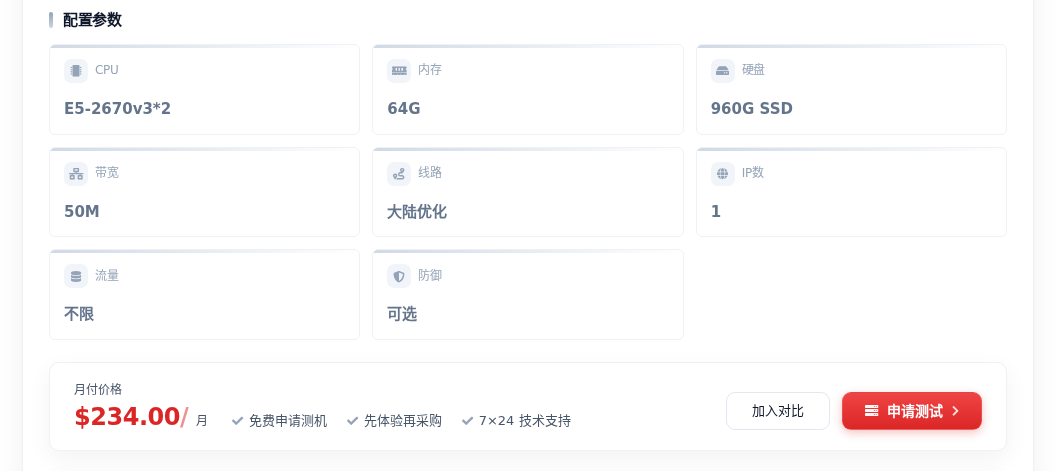
如果团队刚开始验证、预算敏感,可以先用 越南服务器1(E5-2670v3*2 / 64G / 960G SSD / 50M 带宽,234 元/月) 跑 RAG 检索、工单系统和多语言小模型,50M 带宽对文字客服和图片消息足够宽裕,64G 内存也留出了后续加卡的余量。等并发稳定在 20 路以上、需要独立 GPU 推理时,再升级到 越南独立物理服务器(Xeon Gold 6138 / 64G DDR4 / 960G SSD / 20M 带宽,650 元/月),自营机房、大带宽不限流量,适合把 AI 客服作为长期生产系统来跑。
决策建议:会话量日均低于 1000 的卖家,先用低配机器验证模型效果,别急着上 GPU;日均超过 3000 会话、且客服团队已在越南落地的,直接按 20 路并发规划一台带 24GB 显存的物理机,把推理放在本地机房,一年省下的 SaaS 费用和人力成本,通常能覆盖硬件开销。