AI多语言客服落地越南:河内机房延迟与数据合规如何选型部署?
越南跨境电商团队最容易踩的坑,不是模型选不出来,而是客服机器人上线后,越南本地用户发一条消息要等三四秒才回,TikTok Shop 直播间里客户问尺码,AI 还在转圈。问题往往不在模型,而在机房位置和网络线路。另一个隐性风险是数据落地:把越南买家的聊天记录、订单截图一股脑传到境外云 GPU 上,一旦涉及个人信息跨境,后面处理起来很麻烦。这篇上手流程按「先定架构、再估配置、后选机房」的顺序走一遍。
第一步:确定部署形态——云 GPU、物理机还是本地小模型
多语言客服的典型负载是短文本对话加 RAG 知识库检索,不是长文生成。团队规模不同,路线差别很大:
- 日咨询量 500 条以内:7B~8B 量化模型(如 Qwen 系列、Llama 3.1 8B 的 INT4 版本)足够,单卡 24G 显存可跑,配合 Ollama 或 vLLM 部署。物理机成本通常比同规格云 GPU 月付低一个量级。
- 日咨询量 2000 条以上、要并发:考虑 14B 级别模型或双卡,显存按「模型参数量 × 量化位数 ÷ 8 × 1.2 冗余」粗算,14B INT4 约需 10~12G,留出 KV Cache 和知识库向量检索的空间后,24G 卡比较稳。
- 需要越南语、泰语、印尼语多语种:优先选多语料训练充分的基座模型,中文团队常用 Qwen 系列,越南语表现一般够用,上线前务必用真实客服话术做一轮人工抽检。
不建议中小卖家一上来就上 70B 模型,推理延迟和硬件成本都会翻倍,而客服场景 8B~14B 加好的 RAG 知识库,回答质量已经能覆盖大部分售前问答。
第二步:河内机房延迟怎么测、多少算合格
AI 客服的体验由两段延迟叠加:模型推理时间 + 网络往返时间。推理侧 8B 量化模型首 token 一般 0.3~1 秒,剩下就看网络。判断标准可以这样定:
- 越南本地用户到机房 RTT 控制在 30ms 以内,对话体验接近本地应用;50ms 以内可接受;超过 80ms 就要怀疑线路绕转。
- 测法:在河内、胡志明市各找一台 VPS 或本地网络,用 ping 和 mtr 测目标机房 IP,重点看丢包和跳数。河内机房对越南北部用户通常 5~15ms,南部用户 20~35ms,属正常区间。
- 如果客户主要在胡志明市,河内机房仍可用,但要确认服务商国际带宽是否充足,避免晚高峰拥塞。
另一个容易被忽略的点是出口带宽。AI 客服本身流量不大,但如果同机部署直播推流或素材分发,带宽会被吃满。选型时问清楚是独享还是共享、是否不限流量,比只看「50M」这个数字更重要。
第三步:数据落地与合规,先做三件事
越南对个人信息保护有专门法规,跨境电商又涉及买家姓名、电话、地址。落地思路不是「必须全本地」,而是分层:
- 数据分级:聊天原文和订单信息留在越南本地服务器;模型推理日志脱敏后可用于优化,不落原始手机号。
- 知识库本地化:产品资料、售后政策、物流时效这些 RAG 语料放在本地向量库,避免每次检索都跨境请求。
- 备份策略:本地服务器做每日快照,异地备份只存加密后的结构化数据,不存原始对话。
实操上,一套典型配置是:一台越南物理机跑模型推理 + 向量库 + 客服后端,前端接 TikTok Shop / Shopee / 独立站的 webhook。购买环节注意是否需要实名,部分服务商支持匿名购买、多种支付方式,对中小团队起步比较友好。
第四步:配置清单与避坑要点
对比服务商时,按这张清单逐项确认:
- CPU 核心数与主频(推理调度吃单核性能)、内存是否 ≥64G(向量库和并发会话吃内存)
- GPU 型号与显存,是否独享、是否支持直通
- 磁盘类型(SSD 起步,模型加载速度差别明显)与容量
- 带宽大小、是否不限流量、国际出口线路
- 机房位置是否在河内、能否提供测试 IP
- 工单响应速度、是否支持按月起付
常见坑:只看显存不看带宽,模型下载和镜像拉取慢到怀疑人生;用共享带宽跑直播推流,晚高峰卡顿;知识库语料没做清洗,越南语回答夹中英文。上线前用 50~100 条真实历史咨询做回归测试,比任何参数表都可靠。
选购推荐
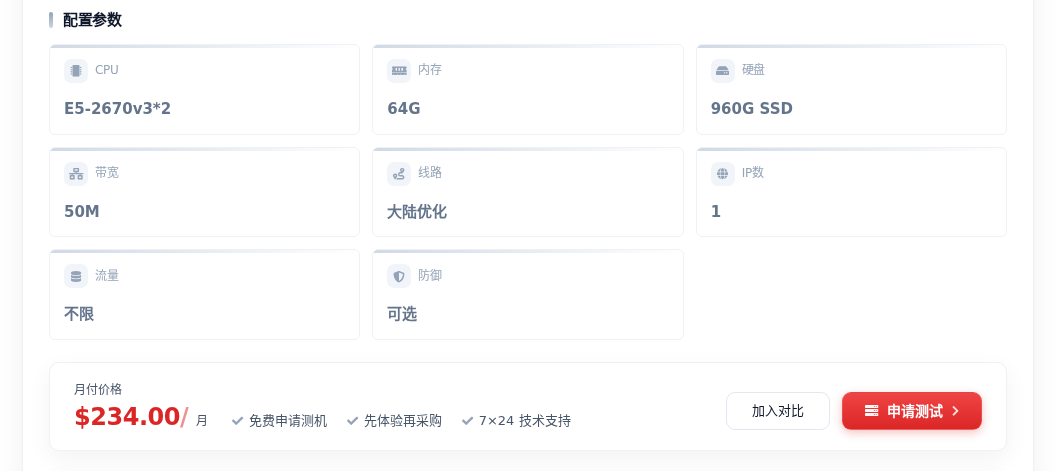
结合上面的需求,起步阶段跑 8B 量化模型加 RAG 知识库,越南服务器 E5-2670v3*2 / 64G / 960G SSD / 50M 带宽是性价比路线,234 元/月的量级适合先验证效果,64G 内存放向量库和客服后端都够用,50M 带宽跑对话和轻量素材分发不吃紧。如果团队已经进入多语种并发、需要更稳的单核性能和独享资源,越南独立物理服务器 Gold 6138 / 64G DDR4 / 960G SSD / 20M 带宽更合适,650 元/月,Gold 6138 的单核表现对推理调度更友好,独立物理资源也便于做数据落地隔离。两款都在河内自营机房,建议先要测试 IP 实测本地延迟再决定。
决策建议:先用低配物理机把 AI 客服跑通、用真实话术验证回答质量,再根据并发量决定是否升级显卡或加机器;机房选河内、线路先测 RTT、数据分层落地,这三件事做对,比盲目堆算力更省钱。