越南服务器跑SeaTalk企业通讯:多租户消息推送下的内存泄漏定位实录
周五下午,运维群里弹出一条告警:越南机房一台跑SeaTalk企业通讯推送服务的服务器,内存使用率从45%一路爬到92%,持续了三个小时没有回落。重启进程后内存短暂下降,两小时后又开始爬升。这台机器承载着十几个租户的消息推送任务,日推送量在百万级,一旦OOM,所有租户的消息都会延迟。下面把这次定位过程整理成问答,供遇到类似问题的同行参考。
Q1:多租户推送场景下,内存泄漏为什么特别难查?
单租户服务的内存问题,通常重启加日志就能缩小范围。但多租户环境下,每个租户的消息格式、发送频率、连接数都不一样,泄漏可能只由某一个租户的特定行为触发。常见诱因包括:
- 连接池未按租户隔离:某个租户建立大量长连接后不释放,连接对象连带缓冲区一起堆积。
- 消息队列消费位点提交异常:消费失败重试时,消息体被反复放入内存队列,积压越来越多。
- 租户级缓存没有过期策略:为提升推送速度做的本地缓存,key按租户维度增长,却没有设置TTL。
排查时不能只看总内存曲线,要先按租户维度拆分监控。通常建议在推送服务里给每个租户打上tag,输出堆内存、活跃连接数、队列深度三个指标。
Q2:从发现内存上涨到定位到具体代码,实际操作步骤是什么?
第一步,确认是泄漏还是正常波动。连续观察两个业务高峰周期,如果内存只在高峰上涨、低谷不回落,基本可以判定为泄漏。
第二步,抓取堆转储。在越南服务器上执行jmap -dump:live,format=b,file=heap.hprof <pid>,注意dump文件可能和堆一样大,要提前确认磁盘余量。如果服务器内存吃紧,可以先jmap -histo:live <pid>看对象直方图,快速判断哪类对象异常多。
第三步,用MAT或VisualVM打开堆文件,按retained size排序,重点看自定义的MessageTask、TenantSession这类对象。这次的问题就出在一个按租户缓存的会话对象上:某租户的SeaTalk回调地址配置错误,推送失败后进入重试队列,重试对象持有会话引用,导致整个租户的会话树无法回收。
第四步,验证修复。将会话缓存改为弱引用,并给重试队列加上最大长度和过期时间,观察24小时内存曲线是否平稳。
Q3:越南服务器选型时,哪些参数直接关系到这类推送服务的稳定性?
推送服务对CPU要求中等,但对内存和网络更敏感。选购时建议对比以下清单:
- 内存:多租户推送建议至少64G起步,JVM堆占物理内存的50%~60%,留足堆外内存和系统缓存。
- 带宽与流量:消息推送是长连接+小包高频,带宽不用极大但要求稳定,不限流量的机型更适合直播推流、视频加速分发等场景,避免突发流量被限速。
- 磁盘:SSD是必须的,堆转储文件和日志写入频繁,机械盘容易成为瓶颈。
- 机房位置:越南自营机房对东南亚用户延迟更低,通常能控制在30~60ms,比绕道新加坡或香港更有优势。
- 购买与支付:部分业务需要匿名购买、无需实名验证,同时支持多种支付方式,工单响应速度也要纳入考量。
市场上越南独立服务器的月付价格一般在200~800元区间,具体视配置和带宽而定。
Q4:有没有现成的机型可以直接跑这类业务?
如果推送服务规模在中等量级,单台机器就能覆盖多个租户。秀米云越南自营机房有两款在售机型比较匹配:
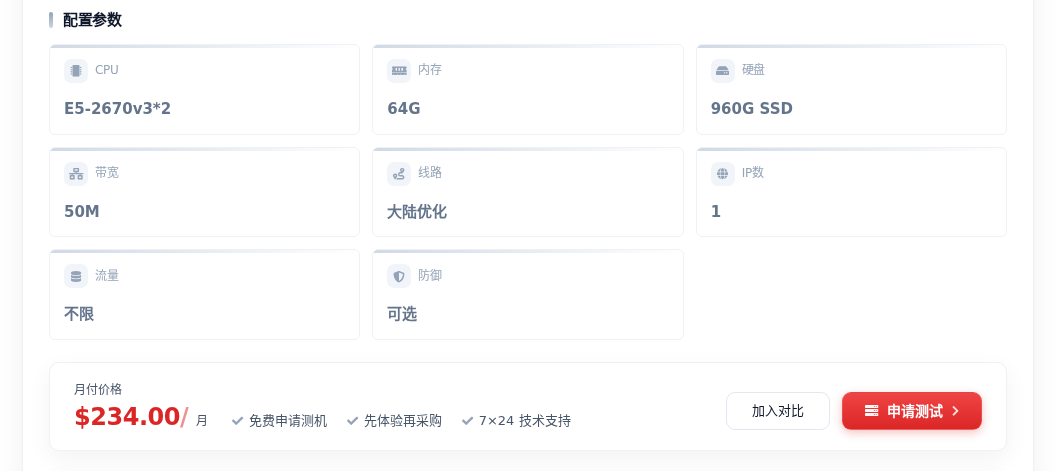
一款是越南服务器1,E5-2670v3*2 / 64G / 960G SSD / 50M带宽,234元/月。双路E5加64G内存,跑JVM推送服务堆内存充裕,50M带宽对长连接推送足够,适合租户数量在几十个以内的场景,性价比突出。
另一款是越南独立物理服务器,Xeon Gold 6138 / 64G DDR4 / 960G SSD / 20M带宽,650元/月。Gold 6138单核性能更强,消息编解码和TLS握手更省时间,适合租户多、推送频率高、对延迟敏感的业务。带宽虽然标称20M,但不限流量,突发推送不会触发额外费用。
两款都支持匿名购买、多种支付方式,工单响应较快,长期运营口碑稳定。选择时主要看租户规模和CPU敏感度:租户少、预算紧选前者;租户多、要求低延迟选后者。
决策建议
多租户推送服务的内存问题,根源往往不在服务器本身,而在代码里的连接、缓存和重试逻辑。建议先按租户维度补齐监控,再决定是否升级配置。如果排查后确认是资源瓶颈,越南自营机房的低延迟和不限流量特性对SeaTalk这类通讯业务是加分项。选型时优先保证64G内存和SSD,带宽按实际并发连接数估算,不必盲目追高。预算有限可以从E5双路机型起步,业务增长后再平滑升级到Gold系列。