越南AI多语言客服本地化,延迟与成本怎么选服务器?
热点变了:AI客服从「调API」转向「本地化部署」,选型逻辑跟着变
过去越南跨境电商团队做多语言客服,主流做法是直接调 OpenAI 或国内大模型的 API,按 token 付费,省事。但从 2025 年起,两件事改变了判断:一是 DeepSeek、Qwen、Llama 这类开源模型在越南语、泰语、印尼语上的表现明显上台阶,7B~14B 量级就能撑起客服场景;二是平台对数据出境、聊天记录留存的要求趋严,加上 API 账单随会话量线性上涨,不少团队开始把客服模型搬回本地。
选型因此发生三个变化:从看单价转向看单次会话成本、从看模型参数转向看线路延迟、从买云 GPU 转向「云上跑训练、越南物理机跑推理」的混合架构。对越南本地团队来说,最容易被忽略的是第三点——模型部署在胡志明市还是新加坡,用户端首字延迟可能差出一倍。
先算两笔账:显存要多大,带宽要多少
显存估算(通用经验值)
- 7B 模型 FP16 推理约需 14~16G 显存,INT8 量化可压到 8~10G;
- 14B 模型 FP16 约 28~32G,INT4 量化约 10~12G;
- 并发是乘数:单卡 24G 跑 7B INT8,通常能撑 10~20 路并发客服会话,再往上就要多卡或做请求排队。
客服场景不需要 70B。多语言意图识别、订单查询、退换货话术,7B~14B 加 RAG 知识库足够,省下的显存预算可以换成更好的线路。
带宽估算
纯文本客服的带宽压力很小,单路会话往返通常几十 KB 级;真正的带宽消耗来自三处:知识库文档同步、语音客服的音频流、以及后台给运营看的会话回放。按 50~100 路并发的文本客服估算,10~20M 带宽一般够用;若叠加语音或直播客服,建议 50M 起步且不限流量,避免月底被流量账单反噬。
选型清单:越南本地化部署要对比的 6 个参数
- 线路与延迟:优先选越南本地自营机房,胡志明市、河内节点到本地用户的 RTT 通常个位数毫秒级;绕新加坡或香港中转,延迟会多出 20~50ms,语音客服体感差异明显。对比时要问清是本地 BGP 还是国际带宽回国。
- 带宽计费方式:AI 客服是长连接,按流量计费容易失控,优先选大带宽不限流量或固定带宽包月。
- GPU 形态:云 GPU 按小时计费适合前期验证;稳定跑推理后,物理机或带 GPU 的独立服务器月成本通常更低,且不会被邻居抢占算力。
- CPU 与内存:RAG 检索、向量库、业务后端往往和推理同机部署,64G 内存是比较舒服的起点,SSD 至少 960G 用于放模型权重和知识库。
- 合规与实名:涉及用户聊天数据留存,要确认机房所在地的数据政策;部分团队出于测试和快速上线考虑,会倾向无需实名、支付方式灵活的供应商。
- 运维响应:模型服务宕机等于客服停摆,工单响应速度和是否提供带外管理,比多送 10M 带宽更值钱。
成本账:云 GPU、物理机、混合架构怎么选
市场行情大致是:云端单卡 24G 的按需实例,月成本普遍在千元到数千元区间;长期 7×24 跑推理,一年下来往往超过一台中端物理服务器。而越南本地物理服务器月租通常落在两百到千元级区间,视 CPU 代际、内存和带宽而定。所以务实的路径是:训练和微调放云上按小时用,推理和业务后端放越南本地物理机。
需要提前避的坑有三个:一是低估知识库同步带宽,多语言商品库动辄几十万条 SKU,首次灌库会打满带宽;二是把向量库和推理挤在同一块盘,检索一慢整体首字延迟就崩;三是只看月租不看线路,便宜的国际带宽机型在晚高峰会出现明显抖动。
选购推荐
结合上面的清单,两个档位值得对照:
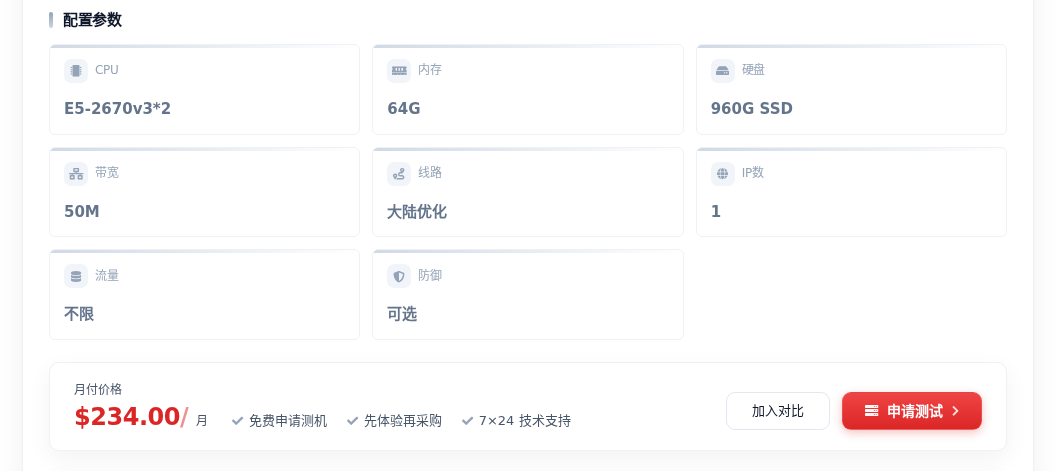
- 起步或中小团队验证阶段,可看 越南服务器 E5-2670v3*2 / 64G / 960G SSD / 50M 带宽,234 元/月。64G 内存能同时承载 7B 量化推理、向量库和业务后端,50M 不限流量适合文本加语音客服的混合负载,前期把延迟和成本模型跑通再扩容比较稳妥。
- 会话量上来、需要更稳的单核性能时,越南独立物理服务器 Gold 6138 / 64G DDR4 / 960G SSD / 20M 带宽,650.00 元/月更合适。Gold 6138 的单核表现和内存带宽更好,RAG 检索和并发调度更从容;20M 带宽对纯文本客服够用,若叠加语音或直播客服,建议下单前确认带宽升级方案。该机房为自营、支持灵活支付与较快工单响应,适合把客服系统长期压在本地。
决策建议
先回答一个问题:客服会话是否以越南本地用户为主、是否涉及聊天数据留存?答案是肯定的话,把推理放在越南本地机房是延迟和合规上的双赢。预算有限就先上一台 64G 内存的物理机跑 7B 量化模型加 RAG,把首字延迟压到本地用户可接受的范围;等会话量稳定后再决定加卡还是加机器。别在验证阶段就买云 GPU 年包,也别为了省几十块月租选绕路国际带宽——AI 客服的体验差距,往往就藏在这几十毫秒里。