越南服务器怎么落地多语言AI客服:从0到1的选型清单
接了一个东南亚电商外包项目,客户要求客服能同时用越南语、英语和中文应答,白天要接直播间咨询,晚上还要跑邮件工单。团队只有两三个人,预算有限,第一反应是买云API,但算下来每天几万次对话的token费用并不便宜,还担心客户数据出境。于是问题变成:能不能在越南本地放一台机器,把开源模型跑起来,既压延迟又控成本?这篇按从0到1的顺序,给出一份可直接对照的选型清单。
第一步:先算延迟账,再决定机器放哪
多语言AI客服的体验瓶颈通常不在模型本身,而在网络往返。用户在马尼拉、胡志明市或雅加达提问,如果服务部署在新加坡或香港,单次请求的RTT一般在30~80ms;放到越南本地机房,对越南境内用户通常能压到10~30ms,对周边东南亚国家视线路质量在30~60ms。对话式客服往往一次回复要串起检索、模型推理、TTS几段调用,延迟是叠加的,所以「本地化」的第一层含义就是把入口放在目标用户附近。
判断标准很简单:拿真实用户分布画一张表,如果越南及周边占比超过一半,优先越南机房;如果欧美用户为主,越南只适合做区域中转节点。带宽方面,纯文本客服并发100路左右,10~20M带宽通常够用;一旦加上语音播报或直播弹幕接入,建议按50M起估,并确认是否不限流量,避免高峰期被限速。
第二步:模型与显存,要多大配置才够
中小企业做多语言客服,一般不会上满血大模型。常见做法是7B~14B量级的开源模型做指令微调,配合RAG知识库回答商品、物流、退换货问题。显存估算按半精度粗算:7B约需14~16G,14B约需28~32G,量化到4bit后大致减半,但多语言能力会有一定损失,越南语这类低资源语种尤其明显,建议先用真实语料做小样本评测再定。
- 只做文本客服、并发不高:单卡24G显存的GPU机型或CPU推理小模型即可起步,先用Ollama或vLLM跑通链路。
- 要接语音、要跑多语言TTS:至少预留一张32G以上显卡,磁盘建议960G SSD起,模型权重和向量库都吃空间。
- 纯CPU方案:E5双路+64G内存可以跑量化后的小模型,响应会慢,适合夜间批处理工单,不适合实时对话。
这里有个常被忽略的点:越南机房的价值不只在延迟,还在「匿名购买、无需实名验证」这类流程上的便利,外包团队给不同客户做隔离环境时,开机器、换IP的节奏会快很多,支付方式也灵活。对个人站长来说,这意味着试错成本低,可以先小配置验证业务再扩。
第三步:成本怎么摊,云GPU还是物理机
市场行情量级上,东南亚云GPU按小时计费,单卡24G档位一个月满跑通常要数千元;物理服务器整机租用则便宜得多,CPU机型月付在两三百到六七百元区间,适合推理压力稳定、需要长期在线的客服场景。真正的成本结构是:机器月费+模型微调的一次性人力+知识库维护。外包团队接多个客户时,建议一台机器跑多个隔离实例,用容器切分资源,把单客户边际成本压下来。
避坑要点:一是别只看标称带宽,问清楚是国际带宽还是本地带宽、是否共享;二是确认机房对直播推流和视频分发的态度,部分线路高峰会抖动;三是数据合规,越南对数据本地化有要求,客户数据尽量留在本地盘并做好备份策略;四是工单响应速度,外包项目出问题时等不起。
选购推荐
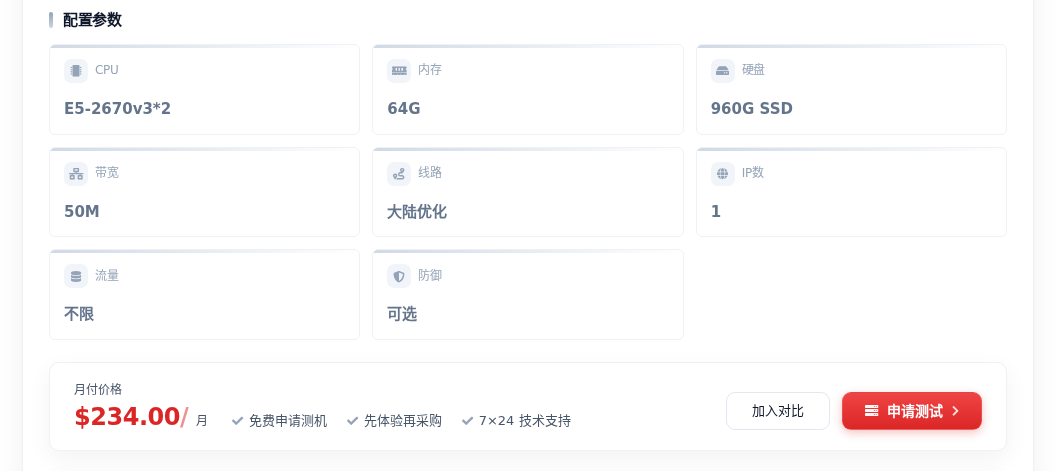
按上面的清单,如果是从0验证多语言客服链路、预算敏感的个人站长或小团队,可以先上越南服务器1(E5-2670v3*2 / 64G / 960G SSD / 50M带宽,234元/月),双路CPU加64G内存跑量化小模型和RAG检索够用,50M带宽对文本客服和轻量直播弹幕接入比较从容,适合先跑通再扩。
如果客户对响应速度和并发有明确要求,准备上14B级模型或加语音链路,建议直接选越南独立物理服务器(Xeon Gold 6138 / 64G DDR4 / 960G SSD / 20M带宽,650元/月),单核性能更好,推理延迟更稳,后续加显卡或扩内存的余地也大。两款都属自营机房、工单响应较快,长期运营口碑稳定,适合外包团队做多客户隔离部署。
决策建议
先用一台中低配越南机器把「入口在本地、模型在本地、知识库在本地」这条链路跑通,用真实用户日志测一周延迟和并发,再决定是否升级到更高主频或加GPU。机器选型看三个数:目标用户RTT、峰值并发会话数、模型量化后的显存占用;成本上优先物理机月付,把省下的预算投到多语言语料清洗和评测上,那才是客服质量的分水岭。