越南服务器承接AI客服外包:延迟与成本怎么权衡
做东南亚跨境电商的团队最近常问一个具体问题:把多语言 AI 客服部署在越南机房,到底是选低配大带宽的越南服务器,还是加钱上高性能物理机?这个纠结背后是两个变量在拉扯——延迟和成本。客服机器人对首字延迟敏感,用户发一句越南语或泰语,等超过两三秒就会关窗口;但多语言模型(Qwen、Llama 系列的小参数版本)跑起来对显存和内存又有硬要求。选错了,要么慢到没法用,要么每月多花几倍的钱养一台跑不满的机器。
热点解读:小模型私有化 + 本地化部署,为什么越南机房突然吃香
过去一年,AI 客服的落地形态明显变了。早期是直接调云端 API,按 token 计费,简单但有两个痛点:一是跨境调用链路长,东南亚用户到北美或国内节点的往返延迟经常在 150ms 以上,叠加模型推理时间,体验不稳定;二是多语言客服涉及订单、地址、退款等敏感信息,部分卖家出于数据合规考虑希望数据落在自己可控的机器上。
于是「小参数模型私有化 + 就近部署」成了中小团队的主流方案。常见做法是用 Ollama 或 vLLM 在本地跑 7B~14B 的量化模型,配一个 RAG 知识库存放商品 FAQ、物流政策、退换货规则,前端接 WhatsApp、Shopee 聊天或独立站客服组件。这套架构对算力的要求其实不算高,但对网络位置要求高:越南、泰国、印尼的买家访问越南机房,通常比访问香港或新加坡节点再绕一圈更直接,尤其是走本地互联的线路。
这也是越南服务器的差异化所在。秀米云越南服务器是东南亚市场方向的自营机房,大带宽不限流量,适合直播推流和视频加速分发;匿名购买无需实名验证,支付方式灵活,工单响应较快。对做 TikTok Shop 直播切片、短剧译制分发、多语言客服外包的团队来说,这类机房的定位刚好卡在「离用户近」和「成本可控」之间。
延迟与成本怎么算:什么场景选什么机器
先给一个判断框架。AI 客服的延迟大致分三段:网络往返、模型首 token 生成、知识库检索。网络往返在越南本地用户到越南机房之间一般在几十毫秒量级,这部分靠机房位置解决;模型生成取决于显存带宽和模型大小,7B 量化模型在合理配置下首 token 通常能压到一秒内;检索则取决于向量库大小和磁盘 IO。
成本侧要算三笔账:机器月费、带宽费用、运维人力。多语言客服的并发通常不高,一个中等规模的独立站,同时在线咨询可能就几十路,峰值集中在促销时段。这意味着不需要一上来就堆 GPU 物理机,先用 CPU 推理或小显存方案跑量化模型,配合缓存高频问答,往往够用。
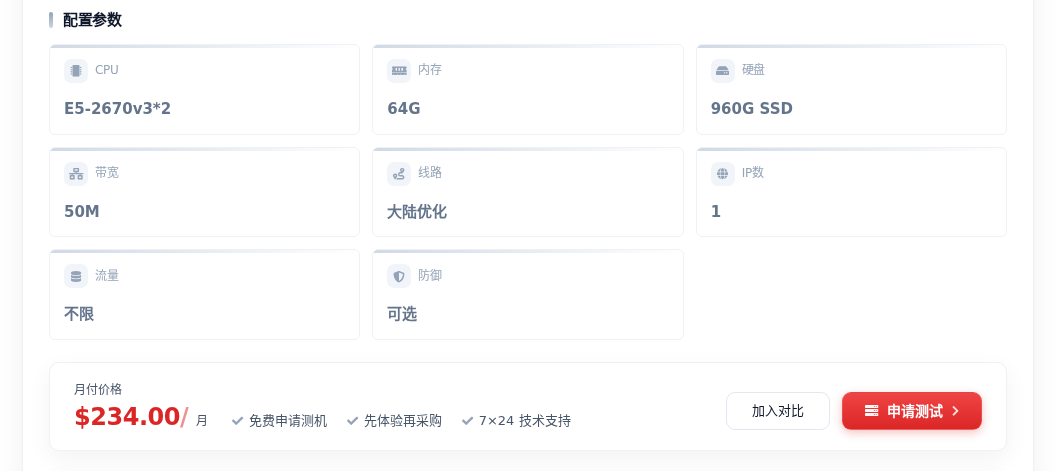
- 轻量起步场景:单站点、日咨询量几百到一两千条、模型用 7B 以下量化版本、知识库文档不多。这类需求对内存和带宽的敏感度高于纯算力,64G 内存、50M 带宽级别的机器就能撑住,月成本在两百多元量级。
- 多站点/外包团队场景:同时服务多个卖家、多语言并行(越南语、泰语、英语)、需要跑 14B 级别模型或做批量素材生成。这类需求更看重单核性能和内存带宽,Gold 6138 这类服务器级 CPU 配 64G DDR4 是常见起点,月成本在六百多元量级。
- 纯 API 调用场景:如果只是把客服请求转发到云端大模型,本地只做路由和缓存,那机器配置可以更低,重点反而是带宽稳定性和 IP 质量。
需要提醒的是,GPU 云主机在越南本地并不像新加坡那样供给充足,价格波动也大。对个人站长和自媒体博主出身的小团队,更现实的路径是先 CPU 推理跑通业务,等咨询量稳定上来再考虑加 GPU 或拆分推理节点,而不是一开始就按大厂架构做预算。
选购时要对比的参数清单与避坑要点
对比越南服务器时,别只看价格和 CPU 型号,下面这几项直接影响 AI 客服能不能稳定跑:
- 内存与是否可扩展:跑本地模型时内存比 CPU 更容易先到瓶颈,64G 是当前较稳妥的起点,确认是否支持后续加内存。
- 带宽类型与是否限流量:客服文本流量不大,但如果同时做直播推流或视频素材分发,不限流量的大带宽机型价值就出来了,要问清是共享还是独享、峰值怎么算。
- 磁盘 IO:向量库检索和日志写入对 SSD 有依赖,960G SSD 是常见配置,注意确认是 SATA SSD 还是 NVMe。
- 线路与回程:面向越南本地用户和面向国内团队管理是两条链路,最好分别测试 ping 和丢包,别只看商家标称。
- 购买与支付门槛:部分团队需要匿名购买、无需实名验证,支付方式是否支持常用渠道要提前确认。
- 工单响应:AI 客服是 7×24 业务,夜间故障能否快速处理,比多核少核更重要。
常见坑有三个:一是把「大带宽」误当成「低延迟」,带宽大不代表到目标用户的路由优;二是低估内存,模型加载到一半 OOM;三是忽略合规,多语言客服涉及用户对话数据,部署前要明确数据留存策略和访问控制。
选购推荐与决策建议
回到最初的问题:轻量机型还是高性能物理机?答案取决于业务阶段,而不是绝对性能。刚起步、单站点、以文本客服为主,优先控制成本,越南服务器1(E5-2670v3*2 / 64G / 960G SSD / 50M带宽,234 元/月)是合理起点,64G 内存足够跑 7B 量化模型加轻量向量库,50M 带宽和不限流量对客服文本加少量素材分发也够用。
如果团队同时承接多个卖家的客服外包、要跑 14B 级别模型或并行做直播推流,单核性能和内存带宽会成为瓶颈,这时更建议上越南独立物理服务器(Intel Xeon Gold 6138 / 64G DDR4 / 960G SSD / 20M带宽,650.00 元/月),Gold 6138 的单核表现和平台稳定性更适合多语言并发推理,20M 带宽对纯客服场景通常够用,若有视频分发需求可再评估带宽档位。
总结一句:先用轻量机型把多语言 AI 客服跑通、测出真实延迟和并发水位,再按数据决定是否升级物理机。别为想象中的峰值买单,也别在内存上省到影响模型加载——这两条比任何参数表都更影响最终体验。