怎样在越南落地RAG知识库:显存要多大、数据放哪里、避开哪些坑
矩阵站群团队做RAG,动机很直接:几十上百个站点要批量产出多语言内容、要自动回答客户咨询、要给SEO编辑做站内检索问答。把知识库放在越南,是为了贴近东南亚访问者、压低带宽成本、同时避开部分地区的实名与内容审查摩擦。但真动手时,两个问题会立刻卡住进度:本地推理到底要多大显存,向量库和原始文档到底落在哪。下面按落地顺序给一份避坑清单。
坑点一:显存按「模型参数量」拍脑袋,忽略向量化与并发
常见误区是只看生成模型的参数量。RAG链路里其实有两段吃显存:embedding模型和生成模型。7B级模型用INT4量化,权重约4~5GB,加上KV Cache与上下文,单卡16GB能跑但并发很低;14B INT4大致10GB出头,建议24GB起步;32B INT4接近20GB,实际要40GB以上才舒服。embedding模型(如bge-m3级别)额外占2~4GB。判断标准很简单:把「权重+KV Cache+embedding+余量30%」相加,再按预估并发×1.5倍留缓冲。
- 日更几十篇、问答并发个位数:单卡24GB(如4090级别)跑14B INT4够用,是最常见的起步档。
- 多站点同时在线客服、批量生成:双卡24GB或单卡48GB,或者生成走量化小模型、embedding单独一台机器。
- 只想验证流程:先用7B INT4加CPU向量检索,16GB显存即可,别一上来买整机。
另一个坑是忽略显存与内存的配比。向量库检索、文档解析、重排模型都吃系统内存,64G内存是RAG机器的常见下限,文档量大时向量索引常驻内存,低于这个数会频繁swap,表现为「GPU没满但响应很慢」。
坑点二:数据落点没想清楚,向量库和原文分家
RAG的数据分三层:原始文档(站群文章、产品资料、客服话术)、切块后的向量索引、会话日志。合理的落点是原始文档与索引同机同盘,避免跨机房拉取;会话日志单独定期归档。判断标准看两点:一是索引重建时能否在本地完成,不依赖外网;二是备份能否整盘导出。
越南机房的现实差异在于:本地自营机房到东南亚访客延迟低,适合把面向越南、泰国、印尼的站点知识库放在这里;但如果站群主要面向欧美,检索请求绕回越南会增加几十毫秒,这时更该把生成层放在访问密集区、只把知识库冷数据放越南。做多语言AI客服的团队尤其要注意:越南语分词与embedding质量直接影响召回,选模型时先拿真实客服语料做召回率对比,别只看榜单。
合规上,越南对数据本地化有要求但执行尺度视行业而定,跨境电商的订单与用户信息属于敏感数据,建议只把「公开内容与产品知识」放越南,个人身份信息留在原业务系统,通过接口按需检索。这一点在矩阵站群场景里反而好操作,因为大部分语料本身就是公开文章。
坑点三:带宽与线路按「够用」估,批量抓取和推流时被打回原形
RAG本身请求不大,但站群团队往往同时跑采集、图片素材同步、短视频分发,带宽瞬间打满。判断标准:按「峰值并发×单请求体积×冗余系数2」估算,再确认是独享还是共享、是否不限流量。做直播推流或多语言短视频分发的团队,20M以上独享带宽是常见起点,50M更适合多路并行。越南自营机房的大带宽不限流量方案在这类场景里比较省心,工单响应速度也影响故障恢复时间,选服务商时把这两项列进对比清单。
选购时要对比的参数清单:CPU核数与主频(文档解析吃CPU)、内存容量与可扩展、SSD容量与是否RAID、带宽是独享还是共享、是否限流量、IP数量(站群需要多IP)、可否匿名购买与支付方式、工单响应时效、是否支持后续加GPU。GPU机器还要问清楚是整卡直通还是虚拟化切分,后者在推理时性能波动明显。
选购推荐与落地顺序
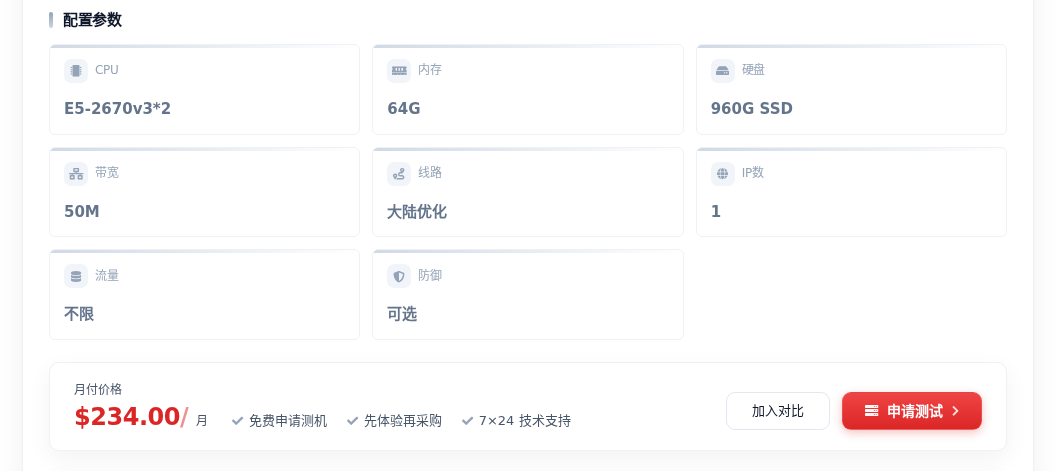
落地顺序建议:先用一台普通物理机跑通文档解析、切块、向量化与检索,确认召回质量,再决定是否上GPU。纯CPU阶段,越南服务器1(E5-2670v3*2 / 64G / 960G SSD / 50M带宽,234元/月)性价比突出,64G内存足够撑起中等规模向量索引,50M带宽应付采集与素材同步不紧张,适合站群团队做知识库底座与多站点内容分发。
需要本地推理、且同时跑多语言客服与批量生成的,建议直接上越南独立物理服务器(Xeon Gold 6138 / 64G DDR4 / 960G SSD / 20M带宽,650元/月),Gold 6138的核数与主频更适合文档解析加推理调度的混合负载,独立物理机也便于后续加装GPU或扩内存。若以视频分发为主,则优先看带宽档位而非CPU。
总结:显存按「权重+KV Cache+embedding+30%余量」估,14B INT4配24GB是多数矩阵站群的合理起点;数据分层落盘,公开语料放越南、敏感信息留原系统;带宽按峰值并发两倍冗余选独享不限流量。先CPU跑通检索质量,再按并发缺口补GPU,比一步到位买整机更不容易踩坑。