越南外包团队跑AI客服要花多少钱?本地化部署显存与整机成本拆解
一个十几人的越南外包团队接了跨境电商的多语言客服项目,客户要求数据不出境、响应延迟低于两秒,团队第一反应是「买张显卡自己跑」。真正开始算账才发现:显存决定能不能跑,整机决定跑多快,带宽决定用起来顺不顺,而这三项在越南本地机房里是分开计价的。下面把账拆开算。
一、显存怎么估:先定模型,再乘系数
多语言客服的主流做法是「开源模型 + RAG 知识库」,常见候选是 Qwen 系列、Llama 系列的中小尺寸版本,以及蒸馏后的推理模型。显存占用大致由三块构成:模型权重、KV 缓存、框架开销。
- 权重:FP16 下每 10 亿参数约 2GB;INT8 约 1GB;INT4 约 0.5GB。7B 模型 FP16 约 14GB,量化后 4~8GB。
- KV 缓存:与并发数和上下文长度成正比。客服场景上下文通常 2K~8K,并发 5~10 路时,7B 模型一般再吃 4~10GB。
- 框架开销:推理框架本身与临时张量,通常预留 2~4GB。
据此给出可落地的判断标准:7B~8B 模型做多语言客服,单卡 24GB 显存可以支撑 5~10 路并发;14B 模型建议 48GB 以上;若要用 32B 级别做质量兜底,80GB 单卡或双卡更稳妥。只做意图分类、工单摘要这类轻任务,7B 量化版配 16GB 显存也能起步,但并发要压到 2~3 路。
越南本地机房的高端 GPU 物理机供给不如新加坡充足,常见做法是「推理放本地、训练与微调租云」。微调用 LoRA 时,7B 模型单卡 24GB 勉强够,14B 建议 48GB 起,这部分按小时租用比长期持有更划算。
二、整机成本账:GPU、CPU 与带宽分开算
把花销拆成四块更接近真实预算:
- 算力:云 GPU 按小时计费,24GB 档位一般每小时几元到十几元,长期跑满一个月往往高于物理机;物理 GPU 服务器月租通常从数千元起,视卡型与机房而定。
- CPU 与内存:RAG 的向量检索、文档解析、多语言分词都吃 CPU。建议至少 16 核、64GB 内存,知识库上万条时内存不要低于 32GB。
- 存储:模型文件加知识库向量库,通常 200GB 起步,SSD 是刚需,机械盘会让模型加载慢到无法接受。
- 带宽:这是越南场景最容易被低估的一项。客服系统要对接 TikTok Shop、Shopee、独立站的 webhook,还要给海外坐席推流式响应,带宽不足时首字延迟会明显变差。20M 独享与 50M 大带宽的体验差异,在多人同时对话时非常直观。
中小团队常见的折中方案是:一台大带宽物理机承载 API 网关、向量库与前端,推理按需调用本地量化模型或云端 GPU。这样既控制月固定支出,又保留扩容空间。
三、落地步骤与越南机房避坑清单
操作路径可以按这个顺序走:先用 Ollama 或 vLLM 在测试机上跑通量化模型,压测出单卡真实并发;再把知识库切片、向量化,确认检索命中率;然后接入客服渠道做灰度;最后按峰值并发反推机器规格。压测时务必用真实的多语言语料,越南语、泰语的分词效果会直接影响 token 消耗。
选机房时逐项对比:
- 是否自营机房,线路到东南亚主要市场的延迟是否稳定;
- 带宽是独享还是共享,超量后如何计费;
- 是否支持匿名购买与多种支付方式,外包团队换汇结算是否方便;
- 工单响应速度,GPU 驱动与 CUDA 环境出问题时能否快速处理;
- 是否允许长期稳定续费,避免项目上线后被临时调价。
常见坑包括:只看显存不看显存带宽,导致并发上不去;把向量库和模型塞在同一块盘上,检索和推理互相拖慢;忽略跨境链路的丢包,流式输出出现卡顿;以及用消费级卡做 7×24 推理,散热和稳定性都撑不住。
选购推荐
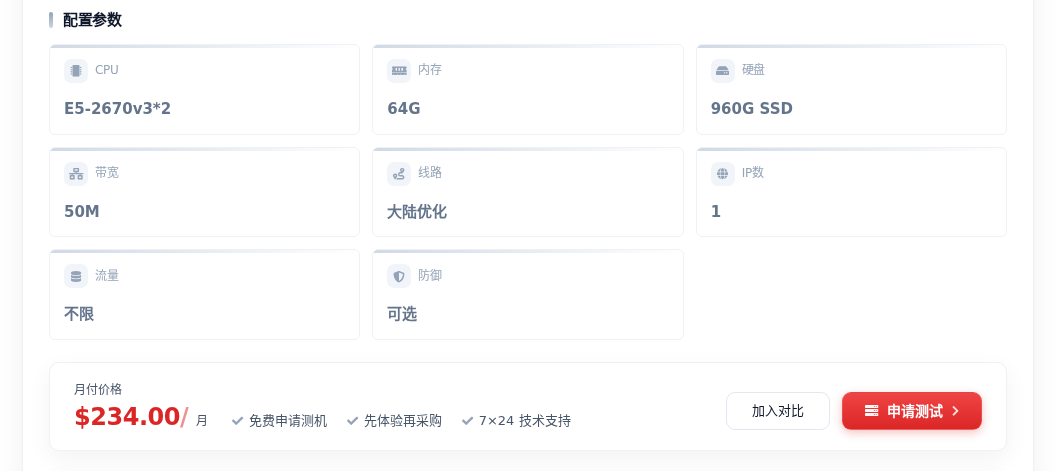
结合上面的成本结构,两类需求对应两种机型。若团队以 API 网关、向量库、多语言前端为主,推理走量化小模型,越南服务器 E5-2670v3*2 / 64G / 960G SSD / 50M 带宽更合适:双路 CPU 加 64G 内存能扛住检索与并发调度,50M 带宽在多人对话和素材分发时余量充足,234 元/月的量级适合作为项目起步机。
若计划把 7B~14B 模型直接放在本地长期跑,且需要更稳的单核性能与独享线路,可考虑越南独立物理服务器 Xeon Gold 6138 / 64G DDR4 / 960G SSD / 20M 带宽,650 元/月,自营机房与工单响应对长期运营更友好,适合作为客服系统的主节点,GPU 推理再按需外挂或后续升级。
总结一句:显存按「模型尺寸 × 量化系数 + 并发缓存」估,机器按「推理 + 检索 + 带宽」三段配,先用小规格跑通再按峰值扩容,比一次性堆高配更符合中小团队的现金流。